昇思25天学习打卡营第十七天|文本解码原理--以MindNLP为例
背景
提供免费算力支持,有交流群有值班教师答疑的华为昇思训练营进入第十七天了。
今天是第十七天,从第十天开始,进入了应用实战阶段,前九天都是基础入门阶段,具体的学习内容可以看链接
基础学习部分
昇思25天学习打卡营第一天|快速入门
昇思25天学习打卡营第二天|张量 Tensor
昇思25天学习打卡营第三天|数据集Dataset
昇思25天学习打卡营第四天|数据变换Transforms
昇思25天学习打卡营第五天|网络构建
昇思25天学习打卡营第六天|函数式自动微分
昇思25天学习打卡营第七天|模型训练
昇思25天学习打卡营第八天|保存与加载
昇思25天学习打卡营第九天|使用静态图加速
应用实践部分
昇思25天学习打卡营第十天|CycleGAN图像风格迁移互换
昇思25天学习打卡营第十一天|DCGAN生成漫画头像
昇思25天学习打卡营第十二天|Diffusion扩散模型
昇思25天学习打卡营第十三天|GAN图像生成
昇思25天学习打卡营第十四天|Pix2Pix实现图像转换
昇思25天学习打卡营第十五天|基于 MindSpore 实现 BERT 对话情绪识别
昇思25天学习打卡营第十六天|基于MindSpore的GPT2文本摘要
学习内容
文本解码原理--以MindNLP为例
回顾:自回归语言模型
根据前文预测下一个单词
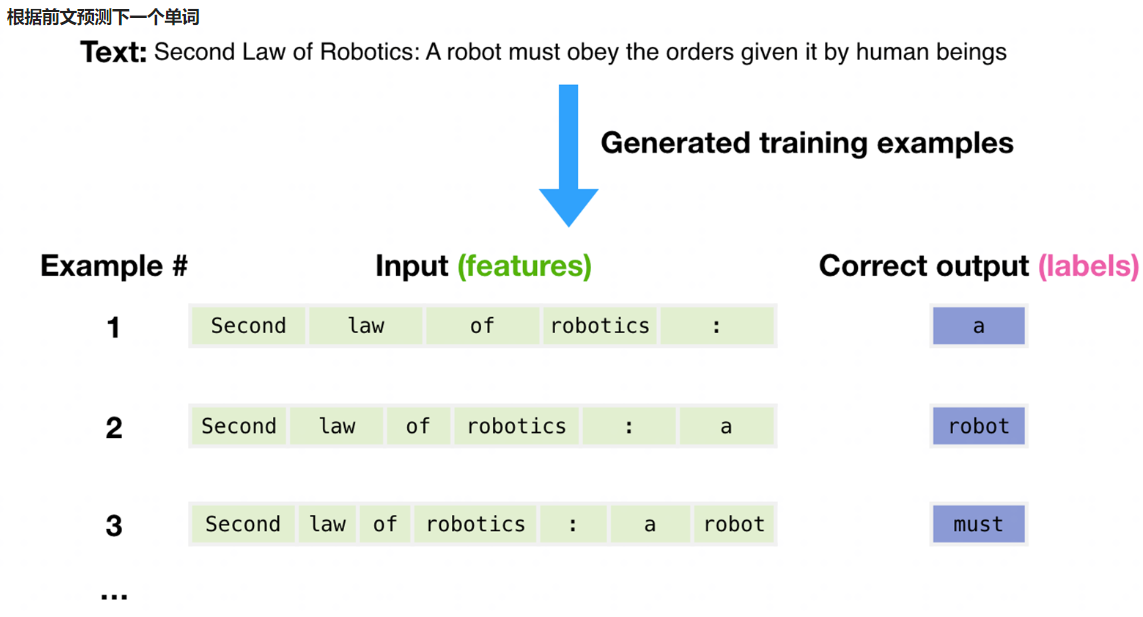
一个文本序列的概率分布可以分解为每个词基于其上文的条件概率的乘积
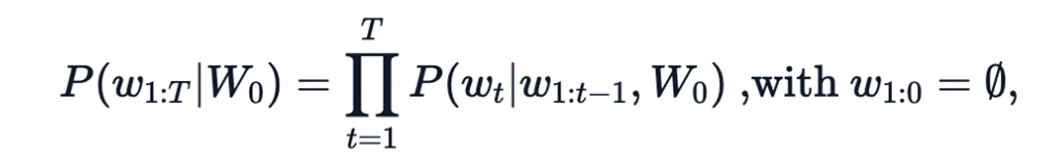
- 𝑊_0:初始上下文单词序列
- 𝑇: 时间步
- 当生成EOS标签时,停止生成。
MindNLP/huggingface Transformers提供的文本生成方法
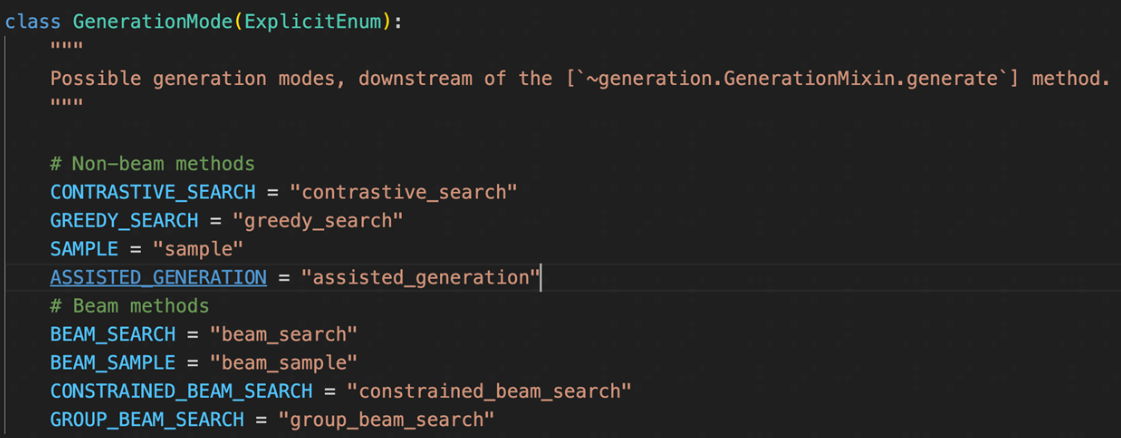
Greedy search
在每个时间步𝑡都简单地选择概率最高的词作为当前输出词:
𝑤_𝑡=𝑎𝑟𝑔𝑚𝑎𝑥_𝑤 𝑃(𝑤|𝑤_(1:𝑡−1))
按照贪心搜索输出序列(“The”,“nice”,“woman”) 的条件概率为:0.5 x 0.4 = 0.2
缺点: 错过了隐藏在低概率词后面的高概率词,如:dog=0.5, has=0.9
Beam search
Beam search通过在每个时间步保留最可能的 num_beams 个词,并从中最终选择出概率最高的序列来降低丢失潜在的高概率序列的风险。如图以 num_beams=2 为例:
(“The”,“dog”,“has”) : 0.4 * 0.9 = 0.36
(“The”,“nice”,“woman”) : 0.5 * 0.4 = 0.20
优点:一定程度保留最优路径
缺点:1. 无法解决重复问题;2. 开放域生成效果差
Repeat problem
n-gram 惩罚:
将出现过的候选词的概率设置为 0
设置no_repeat_ngram_size=2 ,任意 2-gram 不会出现两次
Notice: 实际文本生成需要重复出现
Sample
根据当前条件概率分布随机选择输出词𝑤_𝑡
优点:文本生成多样性高
缺点:生成文本不连续
Temperature
降低softmax 的temperature使 P(w∣w1:t−1)分布更陡峭
增加高概率单词的似然并降低低概率单词的似然
TopK sample
选出概率最大的 K 个词,重新归一化,最后在归一化后的 K 个词中采样
总结
这一节课是理论分析,需要一定的理解能力。

昇腾计算产业是基于昇腾系列(HUAWEI Ascend)处理器和基础软件构建的全栈 AI计算基础设施、行业应用及服务,https://devpress.csdn.net/organization/setting/general/146749包括昇腾系列处理器、系列硬件、CANN、AI计算框架、应用使能、开发工具链、管理运维工具、行业应用及服务等全产业链
更多推荐
 20
 0
- 0


 已为社区贡献20条内容

所有评论(0)